RawBytes 功能实践指南
本文将介绍 RawBytes 的功能定位、技术优势与使用方法。
1 RawBytes 简介
1.1 功能定位
RawBytes 是用于处理原始字节数据的功能,可对二进制数据进行打包、解包、复制和清空,适用于 Socket 通信、协议帧解析、字节数组转换等场景。通过 RawBytes,可将整数、浮点数和字节块按指定格式写入数据帧,也可从数据帧中解析出业务变量,实现二进制协议的灵活处理。
数据处理能力
- 数据打包:支持将整数、浮点数等数值按指定类型转换为二进制字节,并写入缓冲区的指定位置。
- 数据解包:支持从缓冲区指定位置读取字节,并按指定类型解析为整数、浮点数或字节块。
- 字节复制:支持从源数据中复制指定长度的数据到目标数据的指定位置。
- 数据清空:支持清空指定缓冲区,便于重新组帧或测试前初始化。
1.2 技术优势
在脚本中手写拼接二进制字节时,字段宽度、字节序与偏移量均需人工计算。RawBytes 将这几项工作转为显式接口调用,优势如下:
| 优势 | 说明 |
|---|---|
| 协议适配灵活 | 可按业务协议自由组合整数、浮点数和字节块,字段增减时只需调整类型名与位置参数。 |
| 定位明确 | 支持指定起始位置读写,start_pos 直接写在调用处,与协议表逐行对应。 |
| 调试直观 | 可通过十六进制输出直接验证打包和解包结果,便于与协议文档逐字节比对。 |
| 适合 Socket 通信 | 可用于接收、解析、修改并返回二进制数据帧。 |
| 严格校验 | 值域、位置、类型名均在调用时校验,非法即报错并中止;手写拼接则静默通过,错误帧照常发出。 |
校验针对的是参数本身。若丢弃了接口的返回值(见 1.5),模块也不会报错,这一处失误仍需开发者自行规避。
1.3 支持的数据类型
| 数据类型 | 字节数 | 说明 |
|---|---|---|
Bytes | 由长度参数指定 | 原始字节块 |
USINT | 1 | 1 字节无符号整数 |
UINT | 2 | 2 字节无符号整数 |
UDINT | 4 | 4 字节无符号整数 |
ULINT | 8 | 8 字节无符号整数 |
SINT | 1 | 1 字节有符号整数 |
INT | 2 | 2 字节有符号整数 |
DINT | 4 | 4 字节有符号整数 |
LINT | 8 | 8 字节有符号整数 |
Float4 | 4 | 4 字节浮点数 |
说明
位置参数从 1 起算,start_pos = 1 对应数据帧第一个字节。本文全部示例默认采用小端字节序。
1.4 核心接口
| 接口 | 说明 |
|---|---|
packRawBytes | 将变量值按指定类型打包到缓冲区 |
unpackRawBytes | 从缓冲区中按指定类型解包数据 |
copyRawBytes | 从源数据复制一段字节到目标数据 |
clearRawBytes | 清空缓冲区数据 |
toHex | 以十六进制字符串显示数据,用于日志输出 |
local rawBytes = require("aubo.rawbytes")

rawBytes.packRawBytes(value, data, start_pos, "UINT")
rawBytes.unpackRawBytes(data, start_pos, "UINT")
rawBytes.copyRawBytes(source, src_pos, dest, dest_pos, length)
rawBytes.clearRawBytes(data)
1.5 使用注意事项
必须接收返回值
Lua 字符串为不可变对象,packRawBytes、unpackRawBytes、copyRawBytes 不会原地修改传入的缓冲区,而是返回一个新的字符串。若忽略返回值,缓冲区内容不会有任何变化,且不会报错。
rawBytes.packRawBytes(0x5A, out, 1, "USINT")        -- 错误:返回值被丢弃,out 仍为空字符串
out = rawBytes.packRawBytes(0x5A, out, 1, "USINT")  -- 正确
其他约定
start_pos必须大于等于 1,且不得超出缓冲区可写范围。- 解包时源数据长度必须满足目标类型所需字节数。
- 长度模式须传入明确的截取长度。
- 处理
Float4等浮点数据时,比较应允许合理误差。 - 若协议规格调整字节序,应同步更新脚本示例与测试预期。
1.6 在 AuboStudio 中调用脚本
在 AuboStudio 中创建、编写与执行脚本的完整流程,请参考在 AuboStudio 中使用脚本。
2 RawBytes 基础接口示例
以下 6 个示例覆盖打包(两次)、解包、字节截取、字节复制与数据清空 5 类操作。所有示例只涉及单个字段,start_pos 的完整用法在 3.1 展开。
2.1 UINT 打包
将数值 1025 按 UINT 打包:
local rawBytes = require("aubo.rawbytes")

local out = ""
local pos = 1
out = rawBytes.packRawBytes(1025, out, pos, "UINT")
pos = pos + 2
textmsg("out = " .. rawBytes.toHex(out))  -- out = 01 04
break
2.2 Float4 打包
将数值 3.14 按 Float4 打包:
local rawBytes = require("aubo.rawbytes")

local out = ""
local pos = 1
out = rawBytes.packRawBytes(3.14, out, pos, "Float4")
pos = pos + 4
textmsg("out = " .. rawBytes.toHex(out))  -- out = c3 f5 48 40
break
2.3 UINT 解包
从字节 01 04 解包出 UINT:
local rawBytes = require("aubo.rawbytes")

local data = string.char(0x01, 0x04)
local value = rawBytes.unpackRawBytes(data, 1, "UINT")
textmsg("value = " .. tostring(value))  -- value = 1025
break
2.4 字节截取
unpackRawBytes 的第 3 个参数既可传类型名(如 2.3),也可传截取长度(本示例)。长度模式下返回 Bytes 类型的原始字节串,用于处理不定长字段:
local rawBytes = require("aubo.rawbytes")

local data = string.char(0x01, 0x02, 0x03, 0x04, 0x05, 0x06, 0x07, 0x08)
local bytes = rawBytes.unpackRawBytes(data, 2, 4)
textmsg("bytes = " .. rawBytes.toHex(bytes))  -- bytes = 02 03 04 05
break
2.5 字节复制
从源数据第 3 字节起复制 2 字节,写入目标数据第 5 字节:
local rawBytes = require("aubo.rawbytes")

local source = string.char(0x01, 0x02, 0x03, 0x04, 0x05, 0x06, 0x07, 0x08)
local dest = string.char(0x01, 0x02, 0x03, 0x04, 0x05, 0x06, 0x07, 0x08)
dest = rawBytes.copyRawBytes(source, 3, dest, 5, 2)
textmsg("dest = " .. rawBytes.toHex(dest))  -- dest = 01 02 03 04 03 04 07 08
break
2.6 数据清空
重新组帧前清空缓冲区:
local rawBytes = require("aubo.rawbytes")

local data = string.char(0x01, 0x02, 0x03, 0x04)
textmsg("before = " .. rawBytes.toHex(data))   -- before = 01 02 03 04

data = rawBytes.clearRawBytes(data)
textmsg("after  = " .. rawBytes.toHex(data))   -- after  = 空字符串
break
3 完整帧实战
3.1 帧格式与偏移量
本章围绕一段 11 字节控制帧展开,帧格式如下(小端字节序):
| 偏移 | 字段 | 类型 | 字节数 | 说明 |
|---|---|---|---|---|
| 1 | set | USINT | 1 | 固定 0x5A |
| 2~5 | id | UDINT | 4 | 设备编号 |
| 6~7 | cmd | UINT | 2 | 命令字,上限 65535 |
| 8~11 | val | Float4 | 4 | 浮点参数 |
偏移量怎么算:某字段的偏移 = 前一个字段的偏移 + 前一个字段的字节数。
set : 1                -- 首字段,从 1 起
id  : 1 + 1 = 2
cmd : 2 + 4 = 6
val : 6 + 2 = 8
末字节 : 8 + 4 - 1 = 11 -- 末字节偏移 = 当前字段起始偏移 + 当前字段字节数 - 1按上表组帧得到的正确帧如下(id = 1、cmd = 1、val = 3.14):
5a 01 00 00 00 01 00 c3 f5 48 40说明
组帧时会把各字段的值按类型转换为字节序列,多字节字段内部按小端字节序排列,再按字段顺序拼接成完整的 11 字节帧。toHex 只是把字节序列显示成十六进制,方便与协议表逐字节核对。
3.2 正确组帧
按 3.1 的偏移量依次打包,即可产出上面这串字节:
local rawBytes = require("aubo.rawbytes")

local function buildFrame(set, id, cmd, val)
    local d, p = "", 1
    d = rawBytes.packRawBytes(set, d, p, "USINT"); p = p + 1
    d = rawBytes.packRawBytes(id,  d, p, "UDINT"); p = p + 4
    d = rawBytes.packRawBytes(cmd, d, p, "UINT");  p = p + 2
    d = rawBytes.packRawBytes(val, d, p, "Float4")
    return d
end

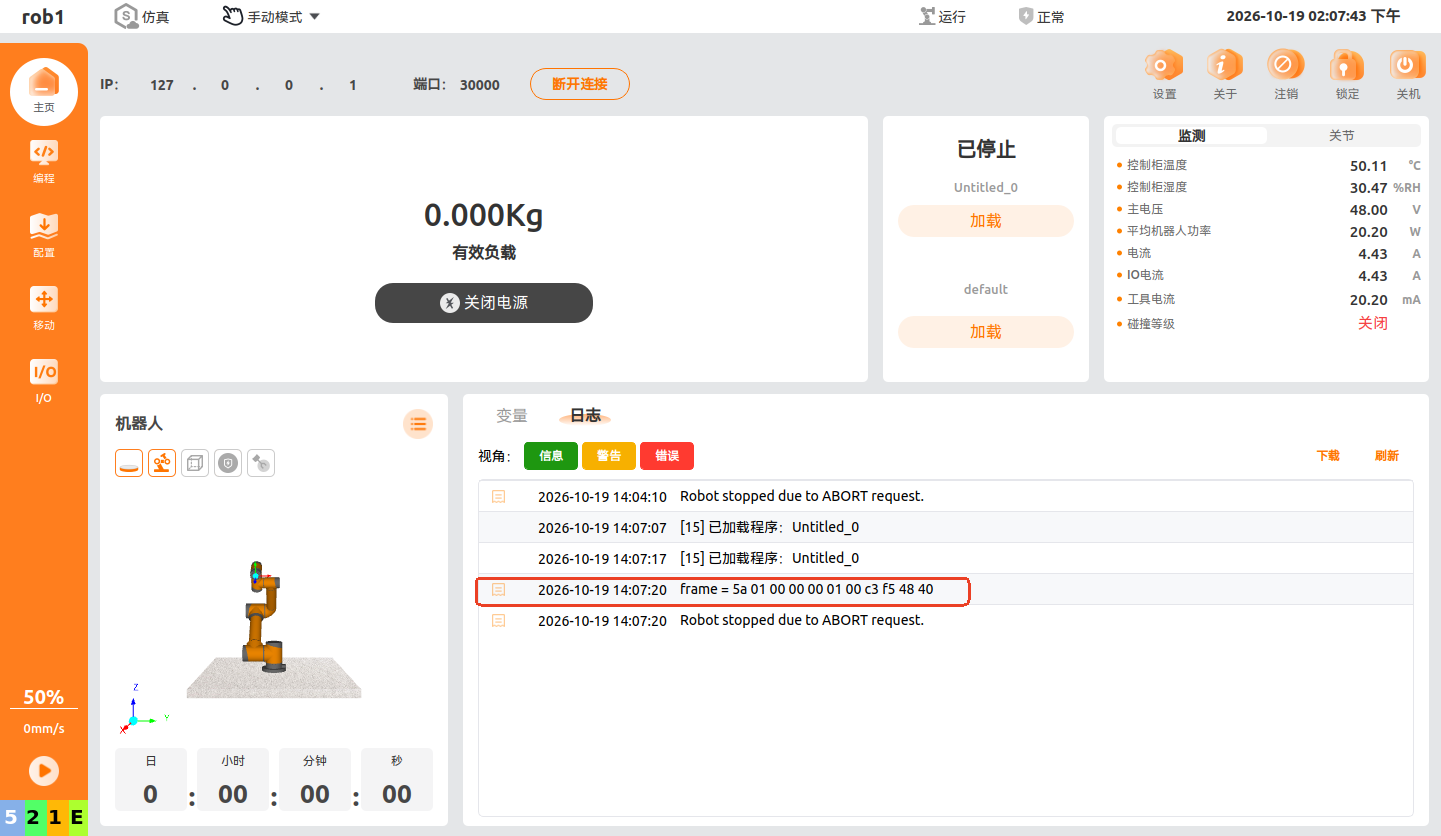
local frame = buildFrame(0x5A, 1, 1, 3.14)
textmsg("frame = " .. rawBytes.toHex(frame))
-- frame = 5a 01 00 00 00 01 00 c3 f5 48 40
break
输出与 3.1 给出的正确帧逐字节一致:字段宽度由类型名决定,偏移量由
p累加得到,无需人工换算。
3.3 解析回帧
收到一帧后,用同一组偏移量反向解析,即可还原各字段:
local rawBytes = require("aubo.rawbytes")

-- 模拟从 Socket 收到的 11 字节回复帧
local rx = string.char(
    0x5A,                     -- set : USINT
    0x01, 0x00, 0x00, 0x00,   -- id  : UDINT
    0x01, 0x00,               -- cmd : UINT
    0xC3, 0xF5, 0x48, 0x40    -- val : Float4
)

local set = rawBytes.unpackRawBytes(rx, 1, "USINT")
local id  = rawBytes.unpackRawBytes(rx, 2, "UDINT")
local cmd = rawBytes.unpackRawBytes(rx, 6, "UINT")
local val = rawBytes.unpackRawBytes(rx, 8, "Float4")

textmsg("set = " .. tostring(set))  -- set = 90
textmsg("id  = " .. tostring(id))   -- id  = 1
textmsg("cmd = " .. tostring(cmd))  -- cmd = 1
textmsg("val = " .. tostring(val))  -- val = 3.1400001049042(Float4 精度)
break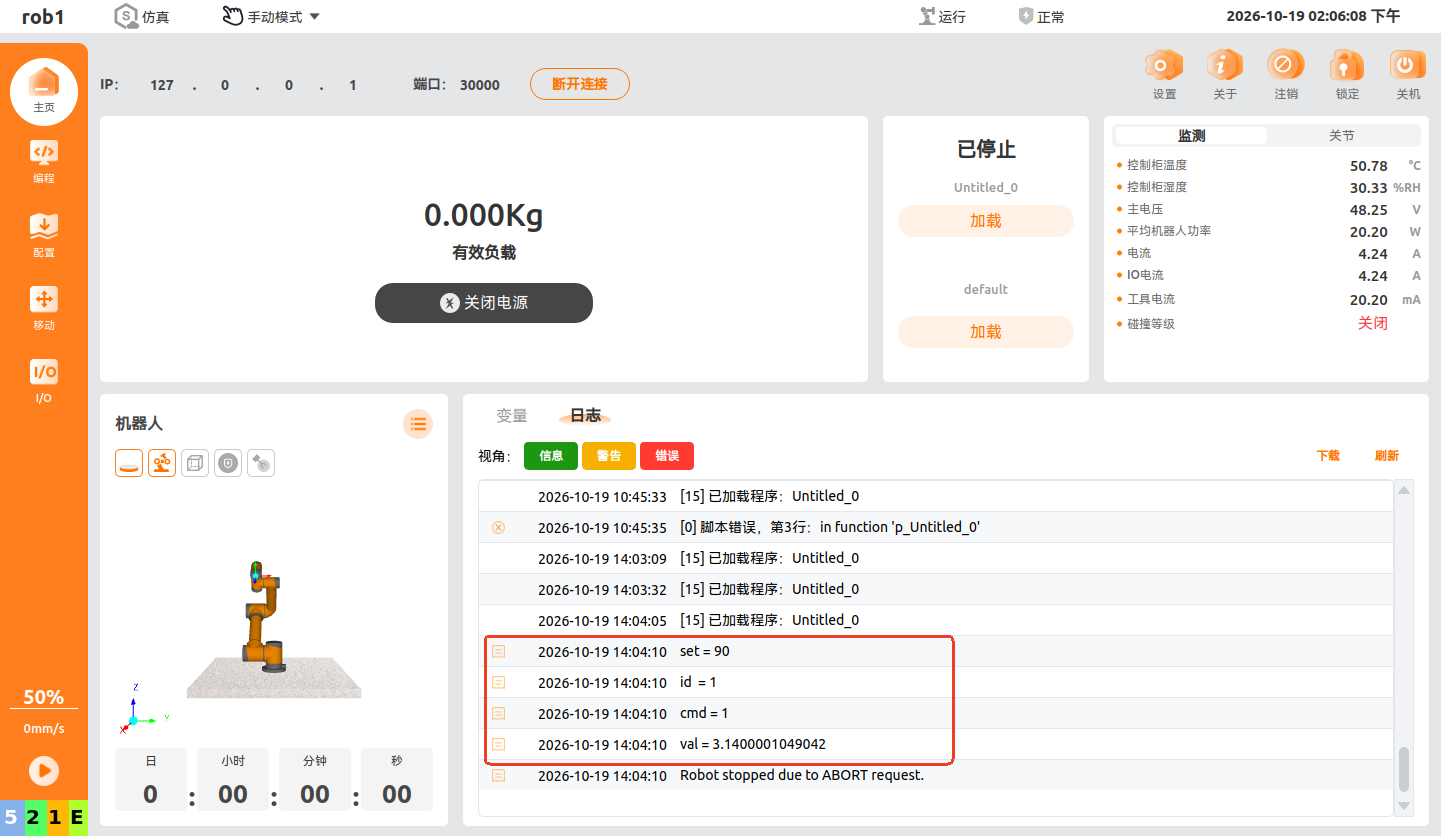
3.4 三类典型错误
处理帧时最常见的三类错误,用 3.1 的帧各演示一次,对比手写拼接与使用 RawBytes 接口的表现。
3.4.1 字段值超出类型范围
cmd 按协议规格为 UINT(上限 65535),业务侧算出 70000。
手写拼接:高位在
>> 8与& 0xFF中被静默丢弃,帧照常发出。示例代码:
lualocal rawBytes = require("aubo.rawbytes") local function udint_le(v) return string.char(v & 0xFF, (v >> 8) & 0xFF, (v >> 16) & 0xFF, (v >> 24) & 0xFF) end local function uint_le(v) return string.char(v & 0xFF, (v >> 8) & 0xFF) end local WANT = 70000 -- cmd 是 UINT,上限 65535 local frame = string.char(0x5A) .. udint_le(1) .. uint_le(WANT) -- 溢出在这里被静默截断 .. string.pack("<f", 3.14) textmsg(rawBytes.toHex(frame)) -- 唯一输出:实际发出的 11 字节帧 breakAuboStudio 运行截图:
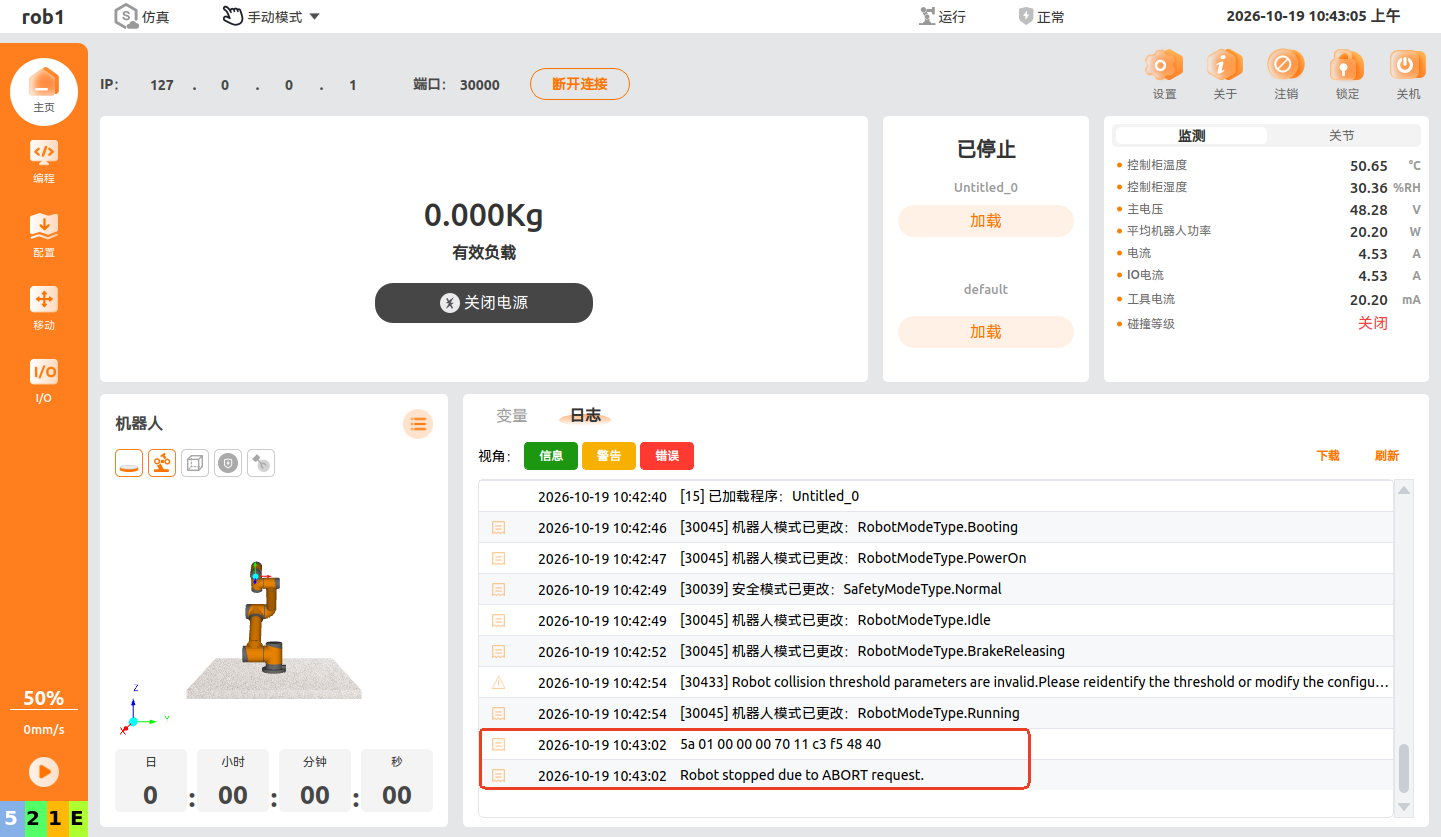
手写拼接输出
5a 01 00 00 00 70 11 c3 f5 48 40,无报错,但与 3.1 的正确帧5a 01 00 00 00 01 00 c3 f5 48 40相比已经出错:只有cmd两个字节不同,70 11即70000截断后的0x1170= 4464。
RawBytes:
packRawBytes立即抛出异常,错误帧不会下发。示例代码:
lualocal rawBytes = require("aubo.rawbytes") local data = "" local pos = 1 data = rawBytes.packRawBytes(0x5A, data, pos, "USINT"); pos = pos + 1 data = rawBytes.packRawBytes(1, data, pos, "UDINT"); pos = pos + 4 textmsg(rawBytes.toHex(data)) -- 唯一输出:报错前已打包的 5 字节 data = rawBytes.packRawBytes(70000, data, pos, "UINT") -- 错误行 breakAuboStudio 运行截图:
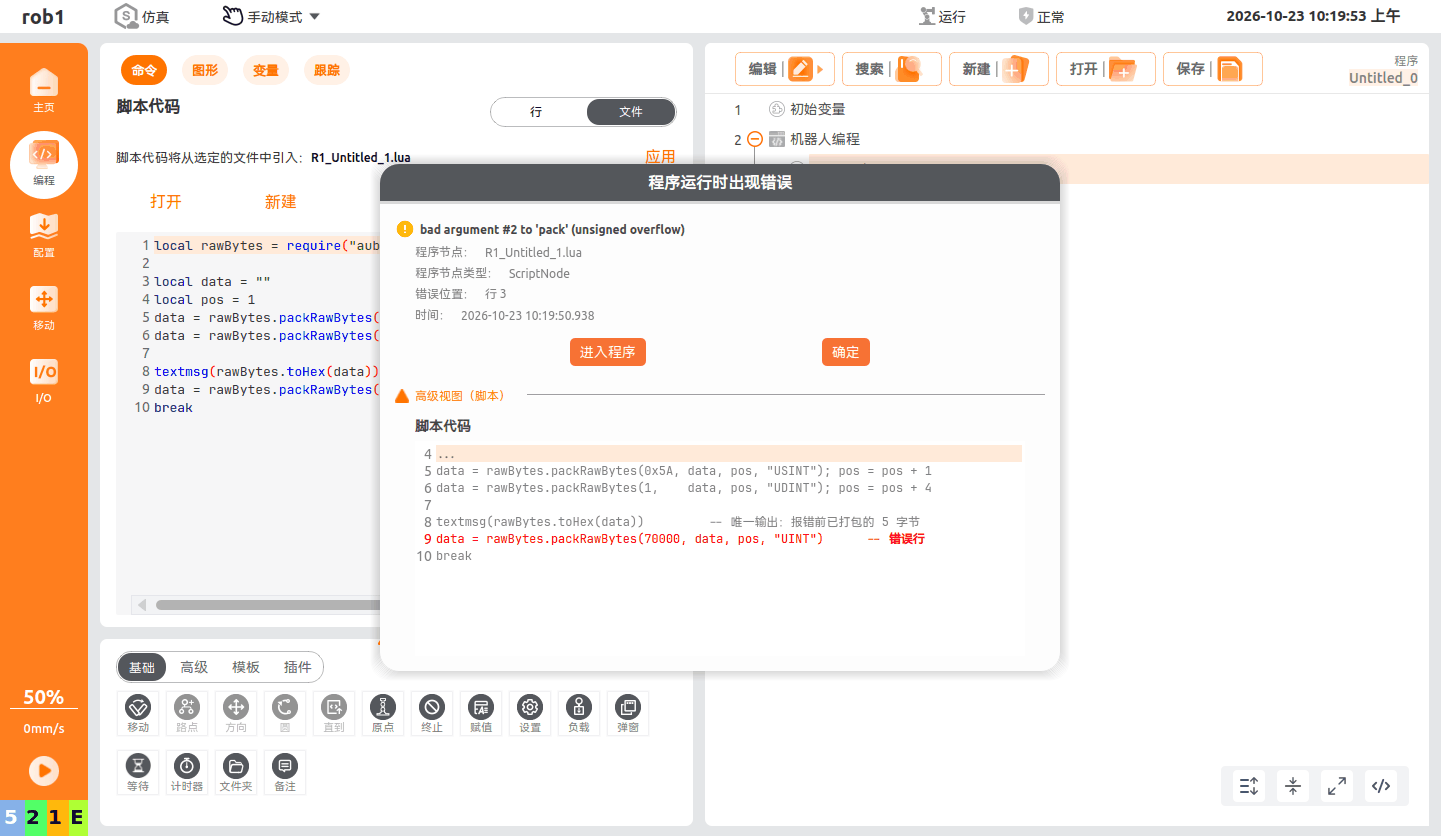
日志窗口仅有
5a 01 00 00 00,报错由弹窗给出:bad argument #2 to 'pack' (unsigned overflow),即打包70000时发生无符号整数溢出(#2是底层string.pack的参数位置,与packRawBytes的参数序号无关)。
3.4.2 修改已有帧时位置算错
将 cmd(第 6~7 字节)改为 0x00FF。
手写拼接:
frame:sub(1, 4)少截一个字节,id尾字节与cmd同时被破坏。示例代码:
lualocal rawBytes = require("aubo.rawbytes") local function udint_le(v) return string.char(v & 0xFF, (v >> 8) & 0xFF, (v >> 16) & 0xFF, (v >> 24) & 0xFF) end local function uint_le(v) return string.char(v & 0xFF, (v >> 8) & 0xFF) end local frame = string.char(0x5A) .. udint_le(1) .. uint_le(0x0001) .. string.pack("<f", 3.14) local patched = frame:sub(1, 4) .. string.char(0xFF, 0x00) .. frame:sub(7) textmsg(rawBytes.toHex(patched)) -- 唯一输出:改错位置之后的 11 字节帧 breakAuboStudio 运行截图:
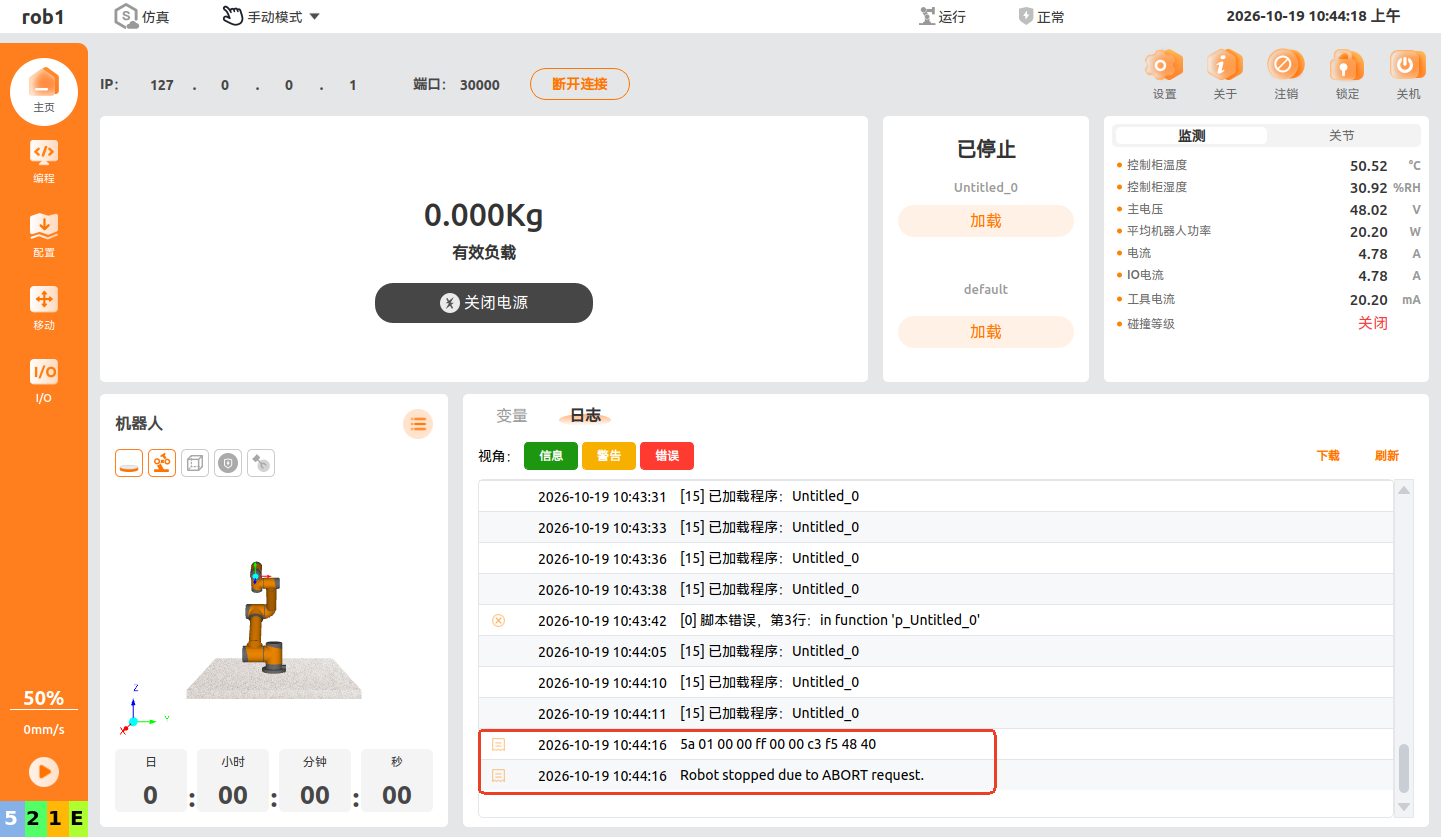
手写拼接输出
5a 01 00 00 ff 00 00 c3 f5 48 40,无报错。对照正确帧可见id变为01 00 00 ff、cmd变为00 00,一处偏移错误同时破坏了两个字段。
RawBytes:位置是显式参数,
6即帧定义表中的偏移量。示例代码:
lualocal rawBytes = require("aubo.rawbytes") local function build() local d, p = "", 1 d = rawBytes.packRawBytes(0x5A, d, p, "USINT"); p = p + 1 d = rawBytes.packRawBytes(1, d, p, "UDINT"); p = p + 4 d = rawBytes.packRawBytes(1, d, p, "UINT"); p = p + 2 d = rawBytes.packRawBytes(3.14, d, p, "Float4") return d end local frame = build() local fixed = rawBytes.packRawBytes(255, frame, 6, "UINT") textmsg(rawBytes.toHex(fixed)) -- 唯一输出:改对位置之后的 11 字节帧 local bad = rawBytes.packRawBytes(255, frame, 0, "UINT") -- 错误行:位置必须从 1 起算 breakAuboStudio 运行截图:
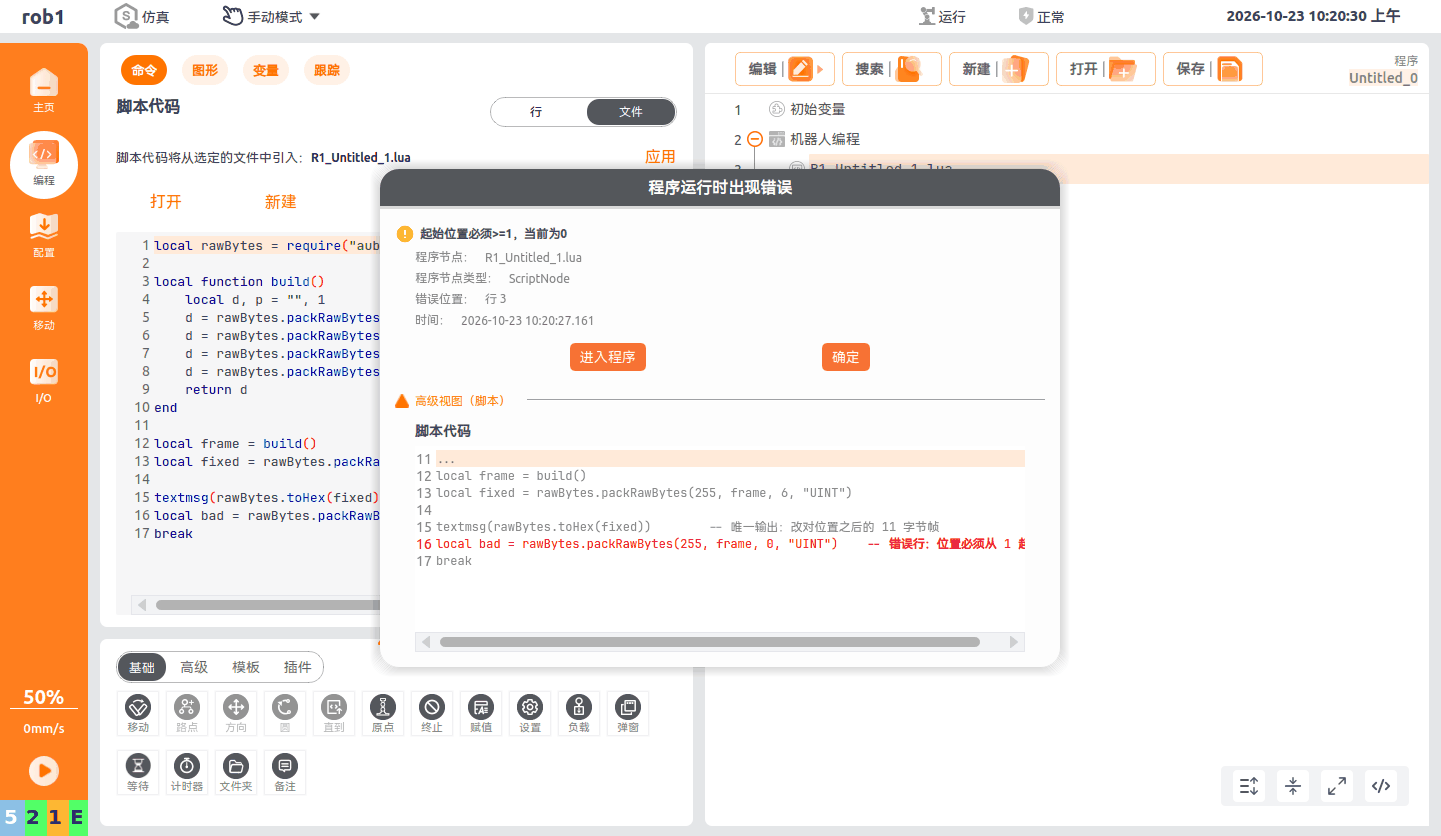
日志窗口输出
5a 01 00 00 00 ff 00 c3 f5 48 40(位置填6的正确结果),随后中止并弹出起始位置必须>=1,当前为0。
3.4.3 字段类型(长度)记错
id 应为 UDINT(4 字节),手写时复用了 uint_le,写成 2 字节。
手写拼接:整帧仅 9 字节,接收方按 11 字节解析时字段整体错位。
示例代码:
lualocal rawBytes = require("aubo.rawbytes") local function uint_le(v) -- 按记忆把 `UDINT` 当成了 2 字节 return string.char(v & 0xFF, (v >> 8) & 0xFF) end local frame = string.char(0x5A) .. uint_le(1) .. uint_le(0x0001) .. string.pack("<f", 3.14) textmsg(rawBytes.toHex(frame)) -- 唯一输出:实际发出的短帧(9 字节) breakAuboStudio 运行截图:
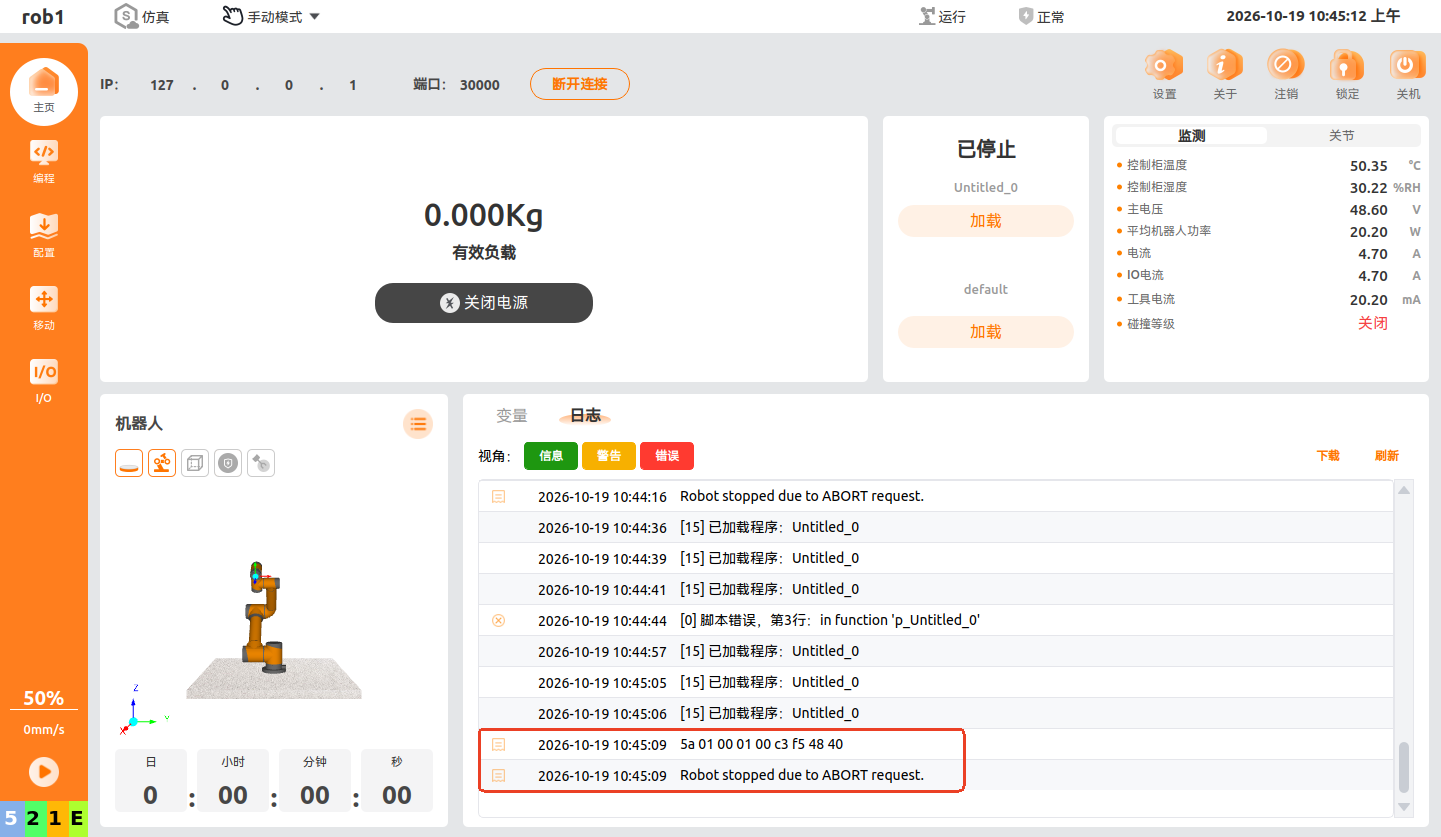
手写拼接输出
5a 01 00 01 00 c3 f5 48 40,无报错,但只有 9 字节,比规格少 2 字节,接收方按 11 字节解析时字段将整体错位。
RawBytes:类型名写错会被模块立即拦截。
示例代码:
lualocal rawBytes = require("aubo.rawbytes") local data = "" local pos = 1 data = rawBytes.packRawBytes(0x5A, data, pos, "USINT"); pos = pos + 1 data = rawBytes.packRawBytes(1, data, pos, "UDINT"); pos = pos + 4 textmsg(rawBytes.toHex(data)) -- 唯一输出:报错前已打包的 5 字节 data = rawBytes.packRawBytes(0x0001, data, pos, "UINT32") -- 错误行:不支持的类型 breakAuboStudio 运行截图:
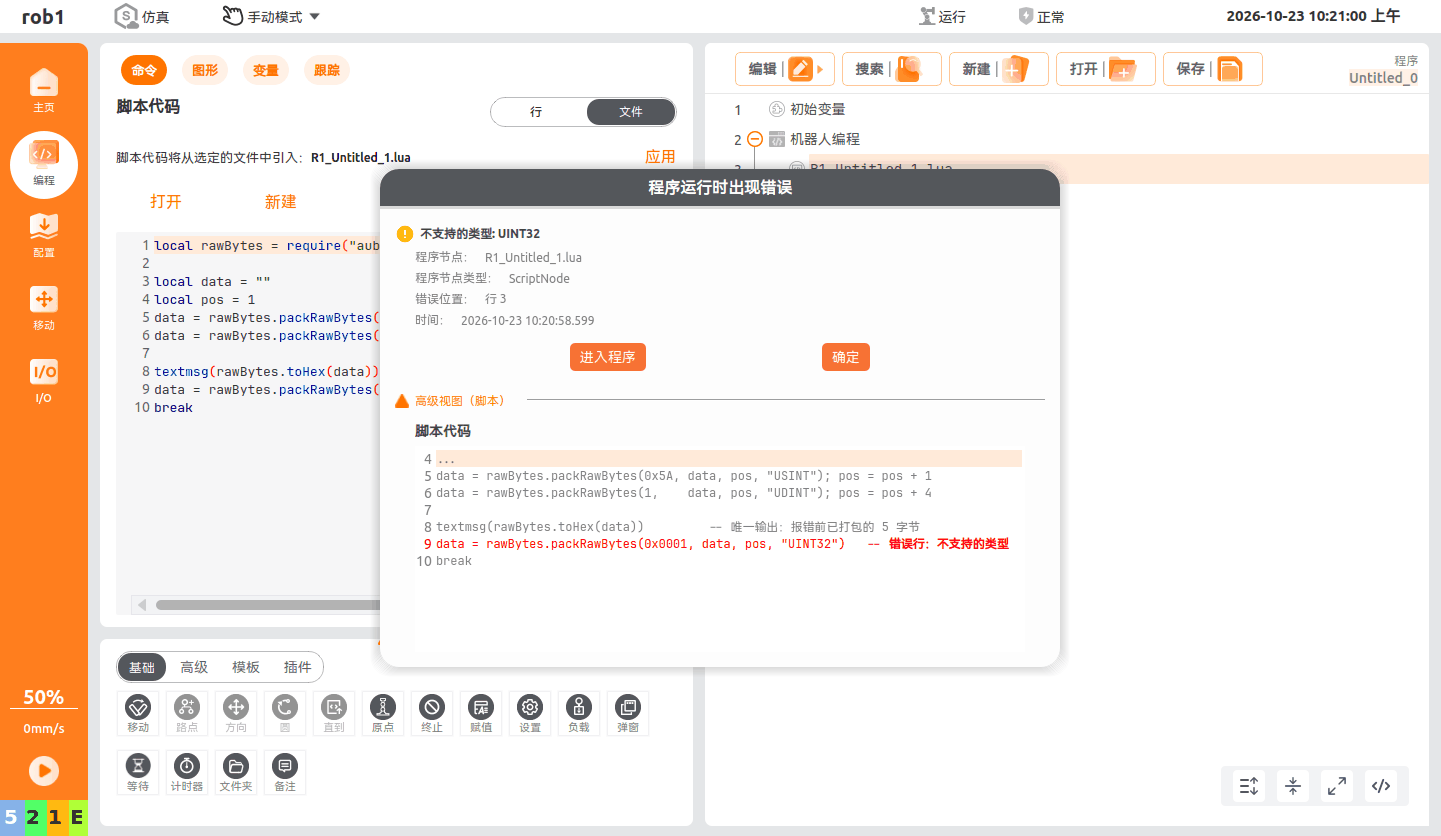
日志窗口仅有
5a 01 00 00 00,报错由弹窗给出:不支持的类型: UINT32。
3.4.4 三类错误汇总
| 错误类型 | 手写拼接的表现 | RawBytes 的表现 |
|---|---|---|
| 值域溢出 | 静默截断,70000 → 4464,错误帧照常发出 | 组帧阶段报 unsigned overflow,错误帧不下发 |
| 位置错误 | id 与 cmd 同时被破坏,无任何提示 | 位置 0 即报错拦截 |
| 类型/长度错误 | 帧长少 2 字节,字段整体错位 | 类型名非法即报错拦截 |
三类错误的共同点:手写版本全部静默通过,只有设备端行为异常后才能反查;RawBytes 版本全部在组帧阶段中止。